Automatisierte Datenverarbeitung in der Zelltomographie: Schritte, Methoden und Grenzen
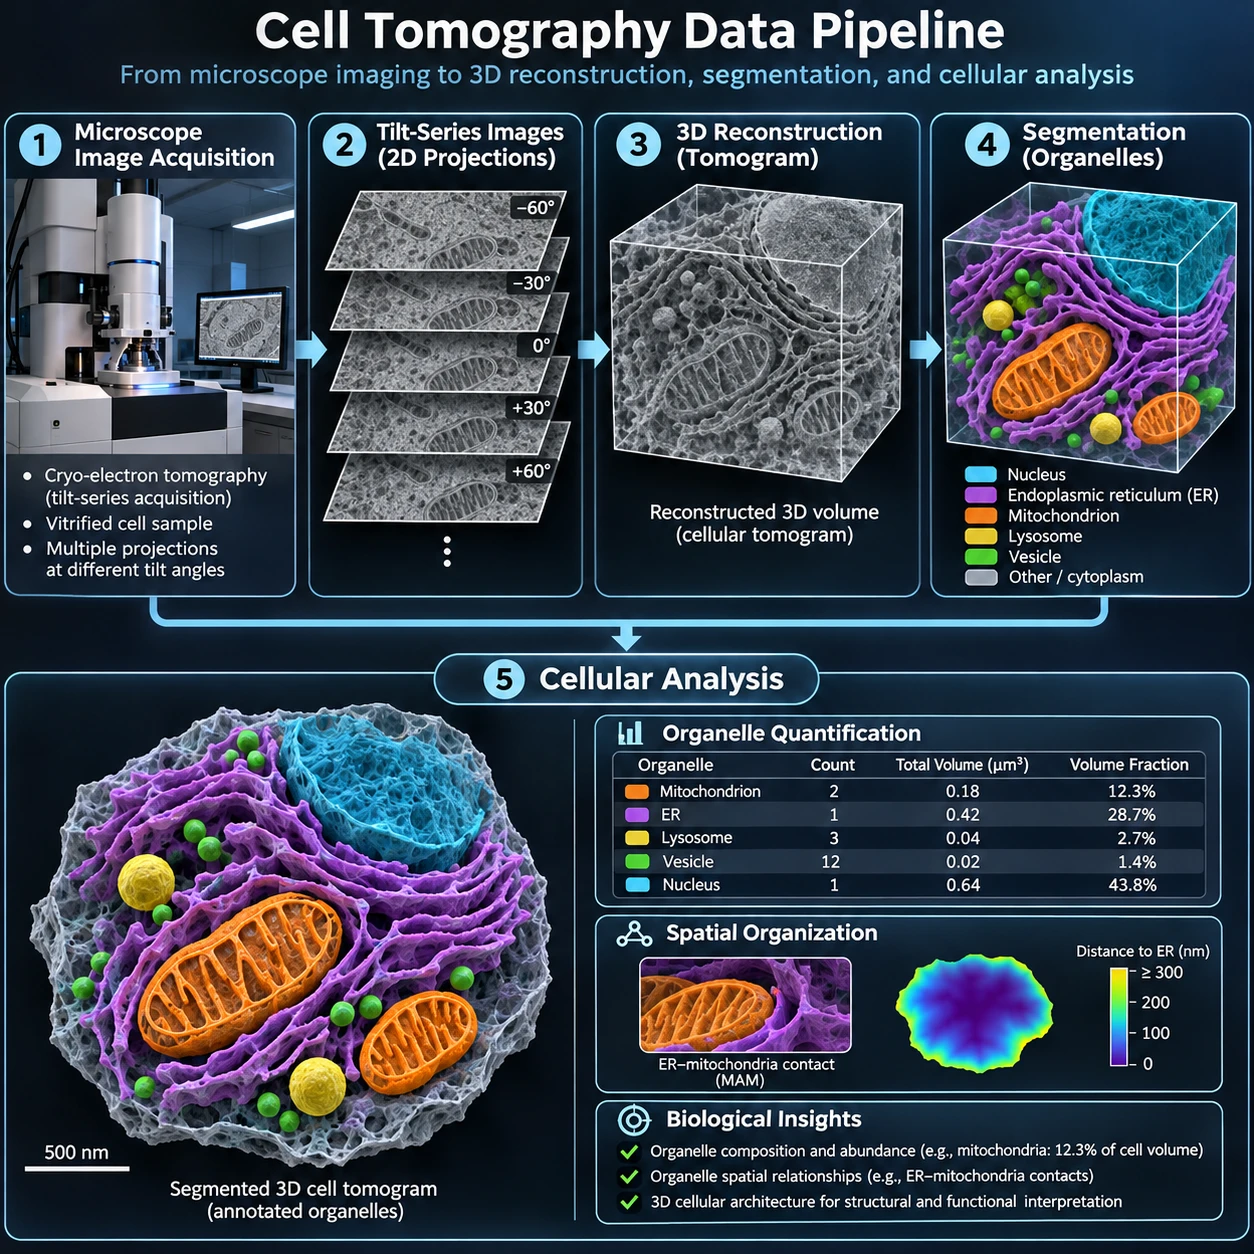
Zelltomographie erzeugt umfangreiche Bilddaten, aus denen Forschende dreidimensionale Informationen über Zellstrukturen gewinnen. Automatisierte Datenverarbeitung verbindet die einzelnen Arbeitsschritte von der Aufnahme bis zur Bildanalyse und macht Abläufe konsistenter. Sie ersetzt jedoch weder die passende biologische Fragestellung noch die Prüfung, ob ein berechnetes Ergebnis tatsächlich zur Probe passt.
Was automatisierte Datenverarbeitung in der Zelltomographie bedeutet
Automatisierte Datenverarbeitung in der Zelltomographie ist die regelbasierte oder modellgestützte Verarbeitung tomographischer Bilddaten mit möglichst wenig manuellen Eingriffen. Sie organisiert wiederkehrende Schritte, damit Bilddaten nachvollziehbar rekonstruiert und für biologische Auswertungen vorbereitet werden.
Der Begriff umfasst mehr als einen einzelnen Algorithmus. Eine Datenpipeline kann beispielsweise Metadaten übernehmen, Aufnahmen prüfen, Projektionen rekonstruieren, Bildbereiche segmentieren und Messwerte exportieren. Die Reihenfolge und die Parameter hängen von der tomographischen Bildgebung, dem verwendeten Mikroskop und der Probe ab. Ein Verfahren für kontrastreiche, isolierte Zellen lässt sich nicht ohne Weiteres auf dichte oder verrauschte Proben übertragen.
Wichtig ist die Abgrenzung zwischen technischer Automatisierung und wissenschaftlicher Interpretation: Software kann Strukturen markieren und quantitative Merkmale berechnen. Welche Struktur biologisch relevant ist und welche Aussage die Messung erlaubt, entscheidet sich erst im Kontext des Experiments. Automatisierung macht die Auswertung effizienter und einheitlicher, aber nicht automatisch richtiger.
Von der Bildaufnahme zur auswertbaren Datenbasis
Eine auswertbare Datenbasis entsteht, wenn Bildaufnahme, Vorverarbeitung und Rekonstruktion als zusammenhängende Pipeline geplant werden. Fehler oder fehlende Informationen in frühen Schritten können sich sonst durch die spätere Bildanalyse fortsetzen.
Der Datenfluss beginnt bei der Aufnahme: Für jede Probe sollten relevante Metadaten wie Aufnahmebedingungen, Pixelgröße, Orientierung und verwendete Einstellungen nachvollziehbar gespeichert werden. Diese Angaben sind nötig, um Bildkoordinaten später biologisch einzuordnen und Messungen zwischen Datensätzen vergleichen zu können. Automatische Prüfungen können fehlende Dateien, unerwartete Bilddimensionen oder auffällige Werte in Metadaten melden.
Anschließend bereitet die Software die Rohdaten je nach Verfahren auf. Dazu können die Sortierung der Projektionen, die Korrektur bekannter Aufnahmeeffekte und die Vereinheitlichung von Dateiformaten gehören. Vorverarbeitung ist dabei kein neutrales Aufräumen: Filter oder Korrekturen können Rauschen reduzieren, aber feine Strukturen verändern. Deshalb sollten Verarbeitungsschritte und Parameter dokumentiert und die Rohdaten unverändert archiviert werden.
Am Ende dieses Abschnitts steht eine kontrollierte Übergabe an die Bildrekonstruktion. Sinnvoll sind Prüfpunkte, die nicht nur den erfolgreichen Programmablauf bestätigen, sondern auch die Datenqualität betrachten: Sind Projektionen vollständig? Gibt es auffällige Ausreißer? Stimmen Bildgröße und Maßstab mit den Metadaten überein? So wird aus einer Dateikette eine überprüfbare Datenbasis.
Rekonstruktion, Segmentierung und Analyse
Bildrekonstruktion überführt tomographische Messungen in ein räumliches Bildvolumen; Bildsegmentierung kennzeichnet darin ausgewählte Zellstrukturen. Die anschließende Bildanalyse berechnet Merkmale, die eine konkrete biologische Fragestellung adressieren.
Bei der Rekonstruktion werden Projektionen oder andere tomographische Messdaten rechnerisch zu einem dreidimensionalen Volumen kombiniert. Das Ergebnis hängt von Aufnahmequalität, Rekonstruktionsverfahren und Parametern ab. Artefakte oder unzureichender Kontrast können Grenzen und Details einer Struktur weniger klar erscheinen lassen. Deshalb sollte die Rekonstruktion an repräsentativen Proben geprüft werden, bevor dieselben Einstellungen auf einen großen Datensatz angewendet werden.
Die Bildsegmentierung teilt das Volumen in Bereiche, etwa Zellgrenzen, Organellen oder andere untersuchte Strukturen. Einfache Verfahren können Intensitätsschwellen oder geometrische Regeln verwenden. Bei komplexeren Bilddaten kommen trainierte Modelle zum Einsatz. Das Resultat ist häufig eine Maske, auf deren Grundlage die Software Volumen, Form, Abstand oder räumliche Verteilung berechnet.
Machine Learning kann besonders dann helfen, wenn Strukturen variabel sind und sich nicht zuverlässig durch eine einzelne Schwelle abgrenzen lassen. Das Modell lernt Muster aus annotierten Beispielen; seine Leistung hängt deshalb von deren Qualität und Repräsentativität ab. Sind Trainingsdaten überwiegend aus einer Probenart oder Aufnahmebedingung erstellt, kann die Segmentierung bei anderen Bedingungen schlechter ausfallen. Prüfen Sie daher sowohl die Masken als auch die daraus berechneten Messwerte.
Die Analyse sollte stets zur biologischen Frage passen. Für die Untersuchung von Zellform können andere Kennwerte sinnvoll sein als für die räumliche Anordnung einzelner Komponenten. Eine präzise wirkende Zahl ist nicht automatisch aussagekräftig, wenn Segmentierungsfehler oder ungeeignete Messdefinitionen ihre Grundlage bilden.
Wo Automatisierung den Forschungsalltag unterstützt
Automatisierung unterstützt den Forschungsalltag vor allem bei wiederkehrenden Verarbeitungsschritten, großen Datensätzen und standardisierten Vergleichen. Sie kann manuelle Routine reduzieren und dafür sorgen, dass Proben nach denselben dokumentierten Regeln ausgewertet werden.
Ein typischer Anwendungsfall ist eine Serie ähnlicher Aufnahmen, in der Zellstrukturen unter mehreren experimentellen Bedingungen verglichen werden. Eine Pipeline kann Dateien einlesen, Volumen mit festgelegten Parametern rekonstruieren, vorab definierte Strukturen segmentieren und Messwerte gesammelt exportieren. Forschende können dadurch mehr Zeit auf die Prüfung biologischer Ausnahmen und die Interpretation verwenden.
Ein weiterer Nutzen liegt in der Konsistenz. Wenn ein Arbeitsschritt manuell von verschiedenen Personen ausgeführt wird, können sich Auswahlentscheidungen und Einstellungen unterscheiden. Eine dokumentierte Verarbeitung reduziert solche vermeidbaren Unterschiede. Das ist besonders hilfreich bei zeitlich getrennten Experimenten oder beim Vergleich innerhalb einer Forschungsgruppe.
Der Vorteil hat eine Grenze: Ein festes Verfahren ist nur so passend wie seine Annahmen. Veränderungen bei Kontrast, Zelltyp oder Aufnahmebedingungen können eine vorher stabile Pipeline aus dem Tritt bringen. Automatisierung eignet sich deshalb gut für wiederholbare Aufgaben, während neue Proben oder unerwartete Phänotypen eine gezielte manuelle Prüfung verlangen.
Qualitätssicherung und Grenzen automatisierter Verfahren
Qualitätssicherung in der automatisierten Zelltomographie kombiniert technische Prüfungen, visuelle Kontrolle und Validierung der Ergebnisse. Sie ist nötig, weil eine Pipeline Fehler schnell und einheitlich auf viele Daten übertragen kann.
Prüfen Sie Ergebnisse an mehreren Stellen, nicht erst am Ende. Bei der Aufnahme geht es um Vollständigkeit und Metadaten; nach der Rekonstruktion um Artefakte und erkennbare Strukturen; nach der Segmentierung um falsch eingeschlossene oder ausgelassene Bereiche. Für die Bildanalyse sollten außerdem Stichproben mit manuellen Referenzmarkierungen verglichen werden. Welche Prüfgröße sinnvoll ist, richtet sich nach der Fragestellung und den Kosten unterschiedlicher Fehler.
- Fehlerquelle: fehlende oder falsche Metadaten. Sie fällt oft erst bei Vergleichen auf. Pflichtfelder und automatische Plausibilitätsprüfungen helfen, bevor die Daten weiterverarbeitet werden.
- Fehlerquelle: ungeprüfte Übertragung von Parametern. Einstellungen, die für eine Probe funktionieren, können bei verändertem Kontrast ungeeignet sein. Testen Sie sie an repräsentativen Beispielen aus jedem relevanten Datentyp.
- Fehlerquelle: Vertrauen in eine saubere Visualisierung. Eine glatte Maske kann biologisch falsch sein. Kontrollieren Sie Grenzfälle, kleine Strukturen und zufällig ausgewählte Beispiele statt nur besonders gelungener Ergebnisse.
Manuelle Kontrolle kostet Zeit und ist selbst nicht frei von subjektiven Entscheidungen. Dennoch bleibt sie wichtig, um systematische Fehler zu entdecken und automatisierte Ergebnisse biologisch einzuordnen. Wo möglich, sollten Prüfende nach klaren Kriterien arbeiten und die Auswahl der Kontrollbeispiele dokumentieren. Eine Pipeline liefert Hinweise und Messwerte; sie bestätigt keine biologische Ursache.
Eine robuste Verarbeitungspipeline planen
Eine robuste Verarbeitungspipeline beginnt mit der Forschungsfrage und hält Rohdaten, Parameter, Softwareversionen und Qualitätsprüfungen nachvollziehbar fest. So können Ergebnisse später überprüft und bei Bedarf mit angepassten Verfahren neu berechnet werden.
Planen Sie die Pipeline in sechs Schritten: erstens definieren Sie, welche Zellstrukturen oder Merkmale untersucht werden; zweitens legen Sie benötigte Daten und Metadaten fest; drittens wählen Sie Rekonstruktions- und Segmentierungsverfahren; viertens testen Sie diese an repräsentativen Proben; fünftens bestimmen Sie Prüfpunkte und Akzeptanzkriterien; sechstens archivieren Sie Eingaben, Parameter und Ausgaben zusammen mit einer Versionsangabe.
Dokumentieren Sie auch Änderungen. Wenn ein Modell neu trainiert oder ein Rekonstruktionsparameter angepasst wird, kann das Messwerte beeinflussen. Eine Versionsverwaltung oder ein nachvollziehbares Protokoll macht sichtbar, welche Auswertung zu welchem Ergebnis geführt hat. Bewahren Sie zudem möglichst die unveränderten Ausgangsdaten auf, damit eine spätere Analyse nicht von bereits bearbeiteten Bildern abhängt.
Die passende Automatisierung ist diejenige, die zur Variabilität der Probe und zum Anspruch der biologischen Aussage passt. Für etablierte, wiederkehrende Aufgaben kann eine weitgehend automatisierte Verarbeitung sinnvoll sein. Bei neuen Bildtypen, schwachem Kontrast oder seltenen Strukturen sollte die Pipeline mehr Prüfungen und manuelle Eingriffsmöglichkeiten vorsehen.
Häufige Fragen zur automatisierten Datenverarbeitung
Welche Verarbeitungsschritte lassen sich in der Zelltomographie automatisieren?
Automatisieren lassen sich unter anderem Datenimport, Metadatenprüfung, ausgewählte Vorverarbeitungsschritte, Bildrekonstruktion, Segmentierung und die Berechnung vorab definierter Merkmale. Welche Schritte ohne manuelle Eingriffe laufen können, hängt von Aufnahmequalität und Probenvariabilität ab.
Welche Rolle spielt Machine Learning bei der Bildanalyse?
Machine Learning erkennt Muster in Bilddaten und kann dadurch Zellstrukturen segmentieren, deren Erscheinungsbild sich nicht einfach mit festen Regeln beschreiben lässt. Die Ergebnisse müssen mit repräsentativen Beispielen geprüft werden, denn unpassende Trainingsdaten können zu systematischen Fehlsegmentierungen führen.
Warum ist eine manuelle Qualitätskontrolle weiterhin wichtig?
Eine manuelle Qualitätskontrolle kann Artefakte, ausgelassene Strukturen und biologisch unplausible Ergebnisse aufdecken, die automatische Prüfregeln übersehen. Sie ergänzt die Automatisierung und sollte anhand dokumentierter Kriterien erfolgen.
Wie lässt sich die Reproduzierbarkeit der Auswertung verbessern?
Bewahren Sie Rohdaten und Metadaten auf, dokumentieren Sie Parameter und Softwareversionen und protokollieren Sie Änderungen an der Pipeline. Wiederholen Sie außerdem Kontrollen an repräsentativen Proben, damit Unterschiede zwischen Datensätzen nicht mit Änderungen der Verarbeitung verwechselt werden.